01
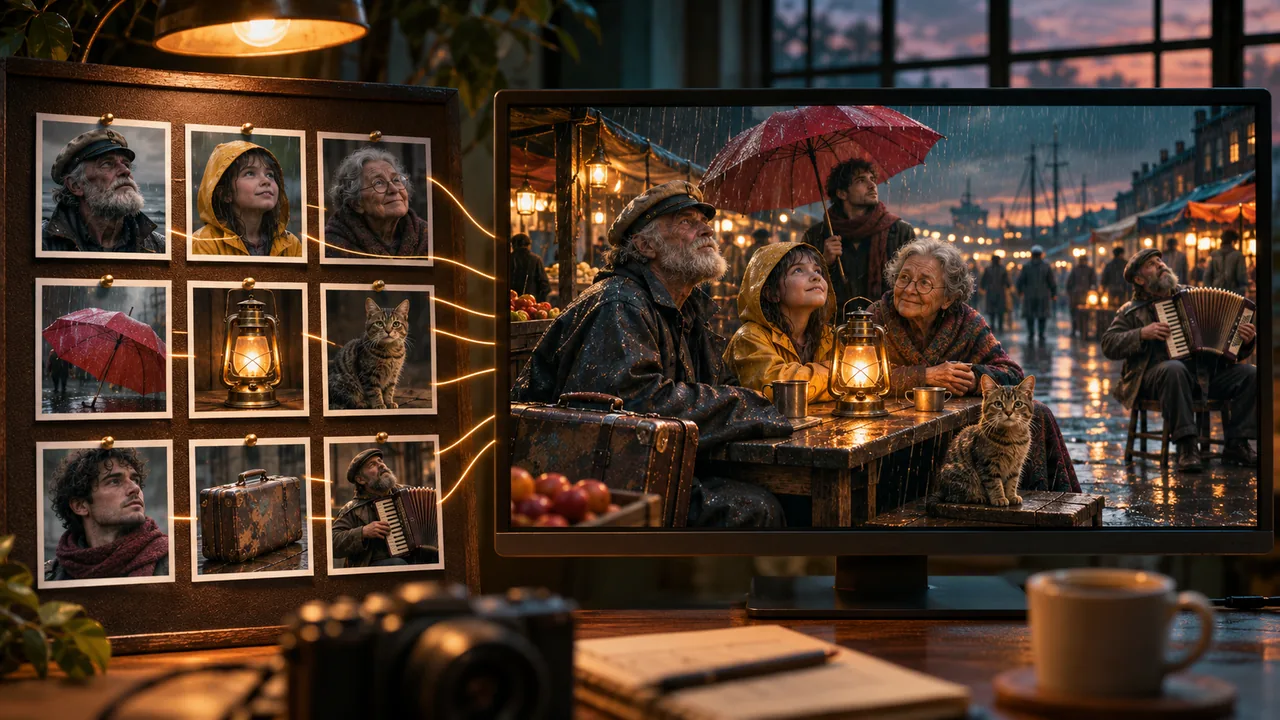
最大9つの参照
H3は参照画像から動画を作るモデルです。クリップ内で保持する必要がある人物や物体の画像を最大9枚渡すと、それらをもとにショットを構成します。これはキャストに必要な入力であり、同じ人物をショット1にもショット6にも登場させられます。
H3は参照画像から動画を作るモデルです。クリップ内で保持する必要がある人物や物体の画像を最大9枚渡すと、それらをもとにショットを構成します。これはキャストに必要な入力であり、同じ人物をショット1にもショット6にも登場させられます。
ぼかされた群衆の中に1人の主役を置くのではなく、それぞれを固有の参照に固定した複数の被写体がいるシーン向けに作られています。
クリップには、映像と同時に作られた独自のオーディオトラックが付きます。Reelfoはデフォルトでこれを要求し、モデルには無音モードがありません。